产品 · 2025 年 6—8 月
动态网页爬虫
基于 Streamlit 与 Selenium 的采集工具,专门对付滚动加载的页面:给它一个列表页网址,说明怎么找到条目——XPath、CSS 选择器、ID、class、tag 或正则——它就会滚动、收集链接、逐页访问、提取内置和自定义字段,再存成 Excel、CSV,或自动建表写入 MySQL。
- 角色
- 独立开发 · 2025 年夏天手工完成
- 时间
- 2025 年 6—8 月
- 技术栈
- Python · Streamlit · Selenium(Edge WebDriver) · BeautifulSoup + lxml · pandas · MySQL
- 项目规模
- 3,404 行 Python · 11 个模块 · 5 种定位方式 + 8 种正则 · 中英双语界面 · 在掘金上的一次运行:60 条链接、60 页、4.6 分钟
- 链接
- GitHub ↗
图表
2025 年夏天的个人项目。图 3 和图 5 来自 2026 年 10 月 11 日用这个工具自带的爬虫类对掘金(juejin.cn)跑的一次带记录的运行:只记录了数量和耗时,没有保留任何页面内容。
- 代码
- 3,404 行Python · 11 个模块 · 中英双语界面
- 定位方式
- 5 + 8XPath、CSS、ID、class、tag · 8 种正则
- 运行:收集链接
- 604 轮滚动 · 10 秒
- 运行:提取页面
- 60 / 60每页都有标题和正文 · 4.6 分钟
一次运行的每一步
- 目标网址 + 定位方式列表页或单篇文章
- Edge WebDriver无头模式 · 页面加载超时 30 秒
- 等待主元素最多 30 秒
- 统计已加载条数够了就收集 · 不够就滚动
- 滚动循环滚到底 · 停 1 秒 · 连续 3 轮无新内容或满 20 次即停
- 收集链接每个匹配元素的 href · 去重
- 逐页访问每页间隔 1 秒
- 提取字段标题 · 正文 · 图片 · 自定义字段
- 导出Excel · CSV · 自动建表写入 MySQL
- 库内搜索对存下的 HTML 做正则匹配
工具运行实录:同一次采集的录屏
Streamlit 界面 · 从掘金抓 40 篇 · 前几秒为实时,之后加速 · 结束于结果表
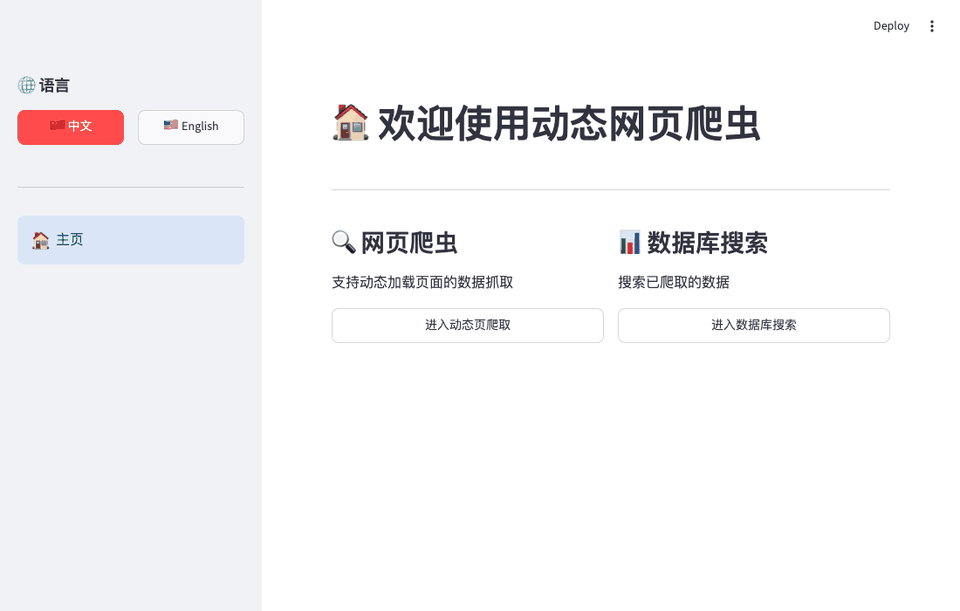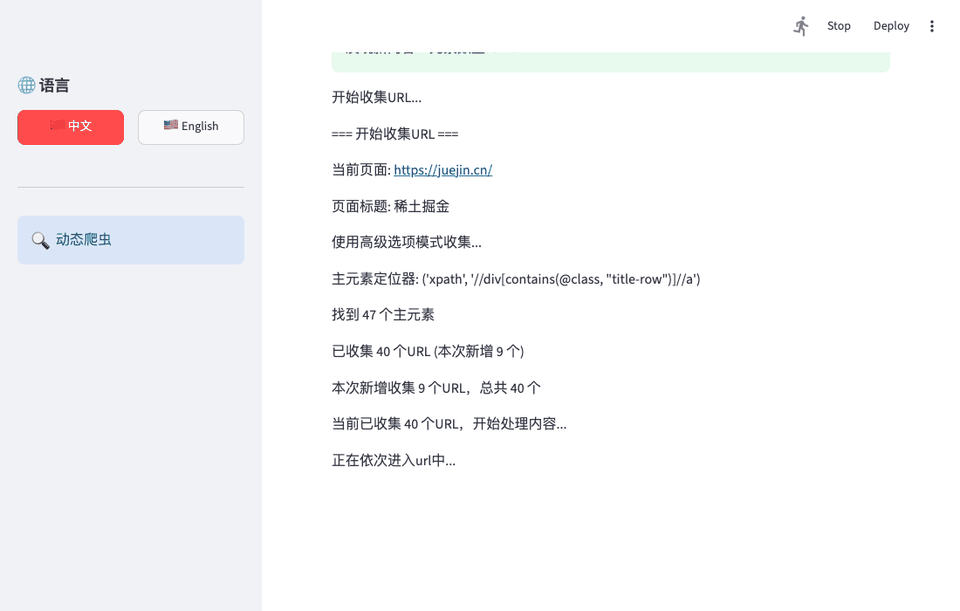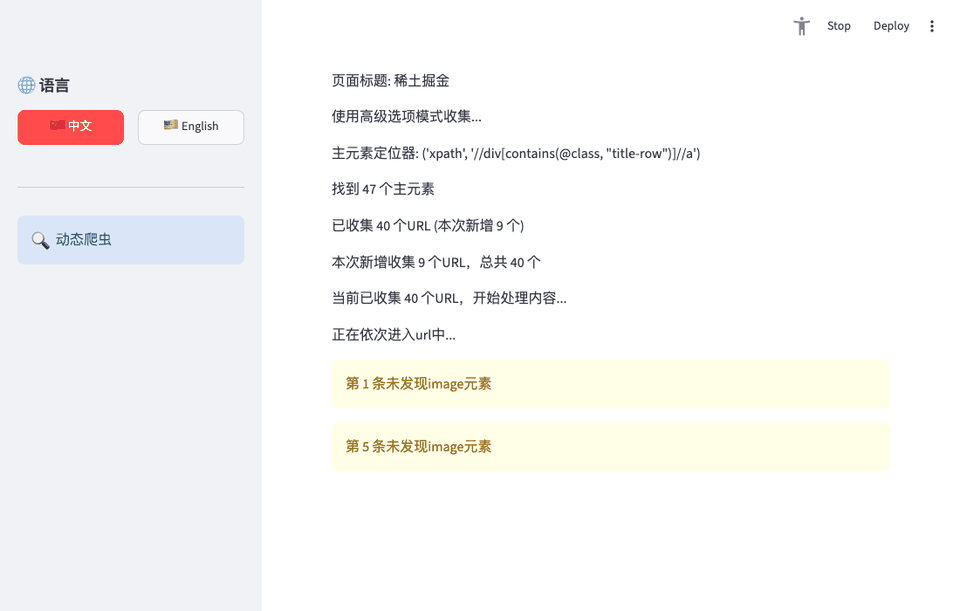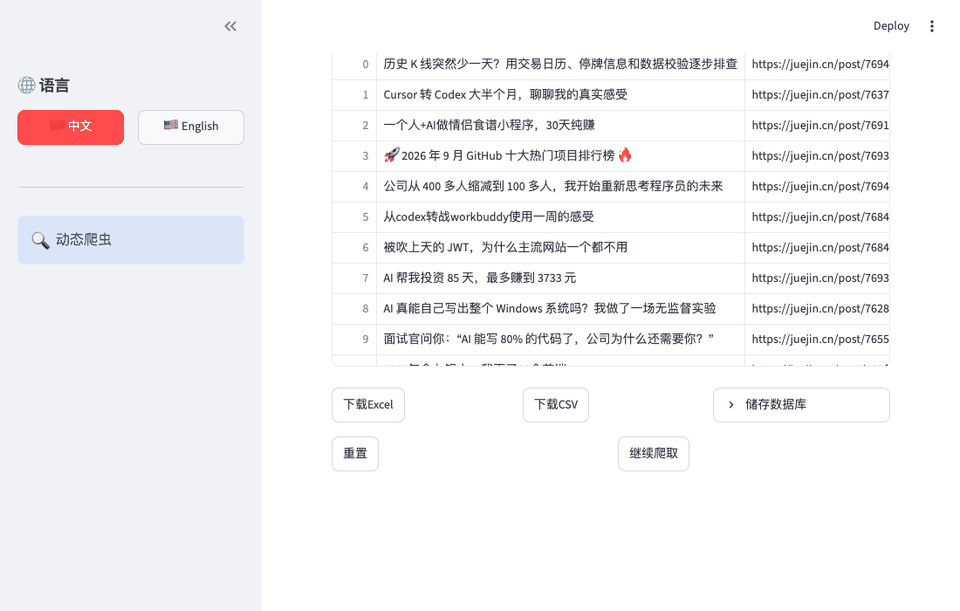
在掘金上跑一次:每轮滚动加载了多少
柱 = 本轮开始时页面上的文章链接数 · 圆点 = 本轮结束时已收集的链接数 · 横轴 = 页面打开后的秒数 · 目标 60
这个工具能对准什么
定位 → 提取 → 存储,按实际实现列出
定位
精确
- XPath
- CSS 选择器
- ID
- Class
- Tag
按模式(正则)
- 网址
- 电话
- 电话(+86)
- 国际电话
- 邮箱
- 图片
- 姓名(2—4 个汉字)
- 年龄
提取
页面模式
- 无限滚动列表 → 文章页
- 单篇文章页
内置字段
- 标题
- 正文
- 图片地址
- 原始 HTML
自定义字段
- 文本
- 链接 / 网址
- 图片
- 任意定位方式
存储与搜索
导出
- Excel(.xlsx)
- CSV
MySQL
- 按数据自动建表
- 类型推断:INT · FLOAT · DATE · DATETIME · VARCHAR(500) · LONGTEXT
- 表名校验防注入
- 批量插入
搜索
- 对存下的 HTML 做正则:网址 · 电话 · 邮箱 · 图片 · 姓名
会话
- 配置以 JSON 保存,下次运行自动载入
- 中英双语界面
这次运行会建出的表
列类型由提取到的 60 行推断 · 填充率 = 有值的行占比
| 列 | MySQL 类型 | 来源 | 填充率 |
|---|---|---|---|
title | VARCHAR(500) | h1.article-title | 100% |
url | VARCHAR(500) | 列表页收集到的链接 | 100% |
content | LONGTEXT | #article-root 的文本 | 100% |
image | LONGTEXT | #article-root img 的 src | 75% |
HTML | LONGTEXT | 页面源码 | 100% |
author | VARCHAR(500) | .author-name .name(自定义字段) | 93% |
published | LONGTEXT | .meta-box time(自定义字段) | 93% |
views | VARCHAR(500) | .views-count(自定义字段) | 93% |
问题
新闻和社区网站的列表是滚动加载的:直接请求页面只能拿到前二十条。要抓它们必须驱动真实浏览器,而想要数据的人——为课程作业收集文章的同学——并不想给每个网站写一遍 Selenium。这个工具要做到的是:给一个网址、说明条目在哪,剩下的它来。2025 年夏天花两个月手工完成。
决策
驱动真实浏览器,先数再滚。 爬虫用 Edge 打开页面,等主元素出现,先数一下已经有多少条;只有不够目标时才滚动(图 1)。每轮滚到底、停一秒、再数一次;达到目标、连续三轮没有新增、或滚满二十次就停。
按选择器或按模式定位。 条目可以精确定位——XPath、CSS 选择器、ID、class、tag——也可以用正则在整页里找:网址、电话、邮箱、图片、姓名(图 4)。自定义字段复用同一套定位方式,所以这次运行不改代码就加上了作者、日期和阅读数。
让数据决定表结构。 导出到 MySQL 时按数据行建表:整数、小数、日期、日期时间各有类型,短字符串是 VARCHAR(500),长的是 LONGTEXT(图 5)。表名经过校验,用户没法通过表单注入 SQL。
记住配置。 每次运行的设置都存成 JSON,下次自动载入;界面中英双语,因为用的人就是两种。
结果
图表背后的那次运行向掘金要 60 条文章链接。页面打开时有 29 条,三轮滚动后到 63 条,爬虫在 10 秒内拿到了 60 条(图 3)。逐页访问这 60 个页面又花了四分半钟,得到 60 行,每行都有标题和正文,自定义字段 93% 有值,图片 75%。工具根据这些行写出了表结构:五个短字段是 VARCHAR(500),正文、图片和原始 HTML 是 LONGTEXT。
局限
一套配置只对应一种页面结构,网站改了 class 名就得重做选择器。页面是逐个访问、固定间隔的,一页四到五秒,超时的页面会被跳过。「连续无新增就停」的规则很粗糙,网络慢的时候会被当成列表到底了。除了间隔之外没有处理 robots.txt 和限流,登录接口只是个占位的勾选框,浏览器只支持 Edge。
04
项目截图
首页:一个应用里两个工具,爬虫和对已存数据的搜索;侧栏切换中英文。 采集配置:目标网址、列表页还是单篇文章、抓多少条、请求头、驱动路径、等待与间隔时间、无窗口模式。 高级筛选:为列表链接、标题、正文、图片各指定一种定位方式和选择器。这就是本次运行用的掘金配置。 数据库搜索:选一张表和一种模式——网址、电话、姓名、邮箱、图片——从存下的 HTML 里把匹配项捞出来。